Basal: jak powstał polski model decyzyjny z otwartymi wagami
1 października ogłoszono premierę basal‑1.0: polskiego modelu z otwartymi wagami, który zamiast zdania zwraca decyzję i jej prawdopodobieństwo. Opisany przez nas we wrześniu Jev robi to samo, ale tylko przez API producenta, bez wag i bez publikacji naukowej. Basalowi towarzyszy 39‑stronicowy raport, w którym przy każdej decyzji projektowej stoi pomiar, także tam, gdzie pomysł się nie sprawdził. 4 października doszła wersja 1.5 z trzema modelami i nowym, ukrytym testem, który zmienia obraz porównania z Jevem.
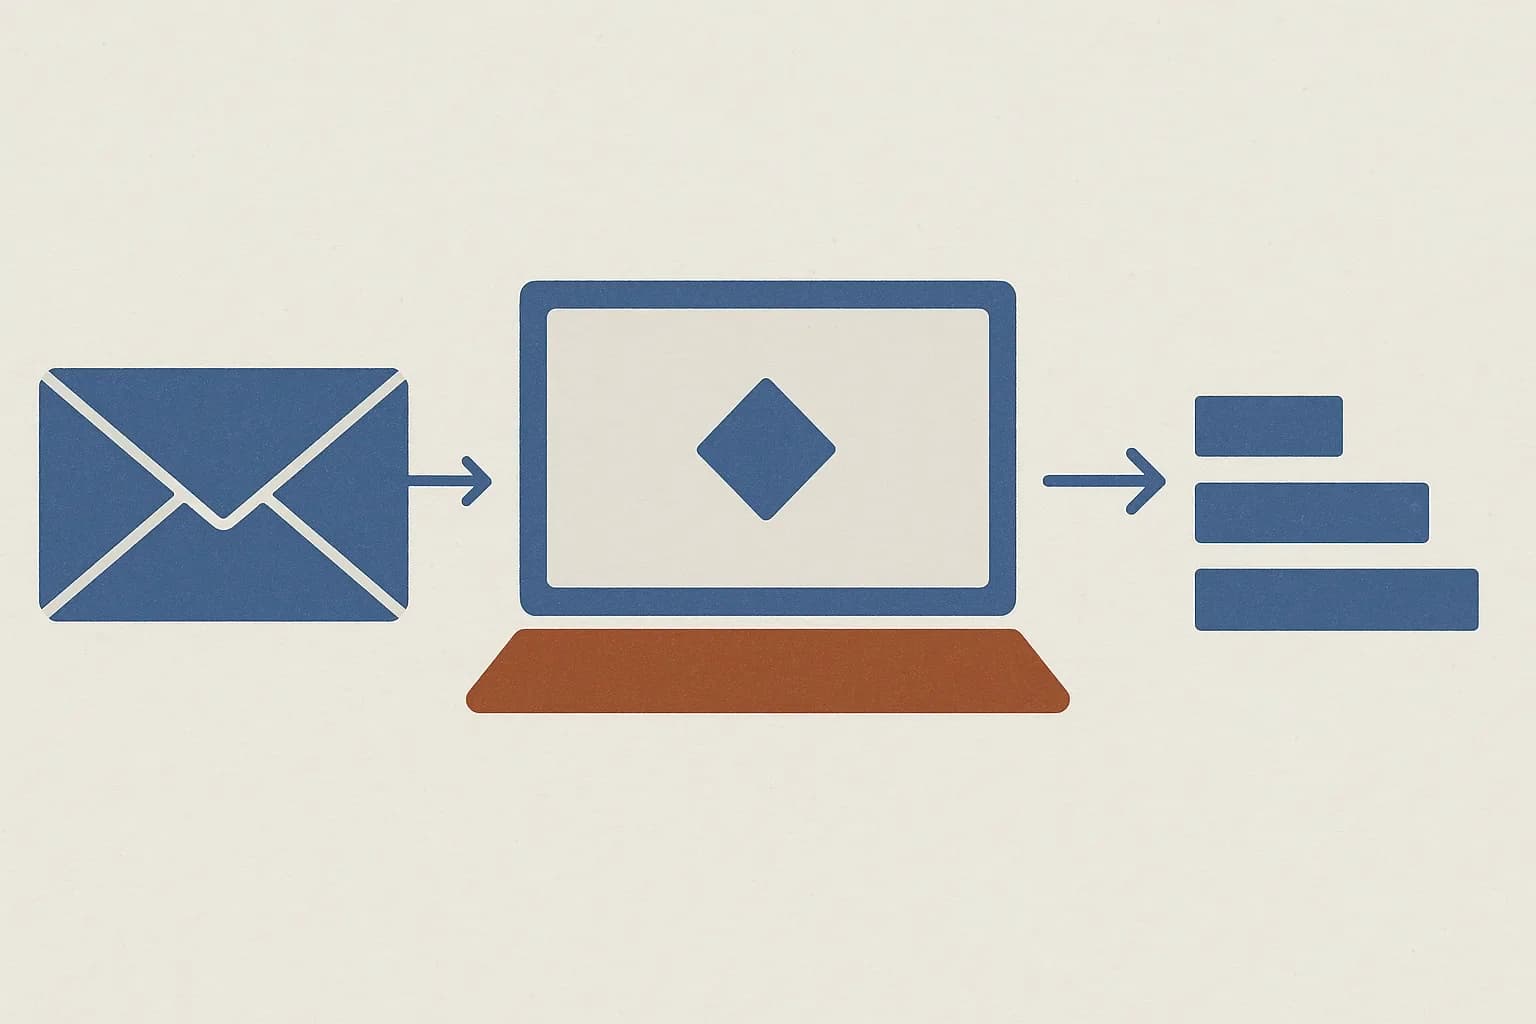
Basal działa jak Jev, tyle że na Twoim sprzęcie. Wysyłasz treść (wiadomość, dokument albo JSON), pytanie i listę dozwolonych odpowiedzi. Wraca prawdopodobieństwo każdej z nich, bez ani jednego wygenerowanego słowa. W przykładzie z raportu klient pisze, że nie może zalogować się do bankowości internetowej, a model spośród trzech działów wskazuje wsparcie bankowości elektronicznej z pewnością 0,999, w 10,5 ms na serwerowej karcie H100.
Za modelem stoi Remigiusz Kinas (afiliacja ai5), jedna z pięciu osób podpisanych pod raportem technicznym Bielik v3 Small. Pierwsza wersja ma dwa modele, basal-1.0-4.5B i mniejszy basal-1.0-1.5B, oba powstały z dostrojenia Bielika v3 od SpeakLeash. Co zmieniła wersja 1.5, opisujemy na końcu. Wagi i silnik są na licencji Apache 2.0, która pozwala na użycie komercyjne, a serwer przyjmuje zapytania w formacie Jeva, pod tym samym adresem POST /v1/systemone.
Pomysł: odczytać literę, niczego nie pisać
Pod spodem nie ma nowej architektury. Opcje trafiają do zwykłego modelu językowego jako litery od A do J, początek odpowiedzi jest wpisany za model, a decyzją jest rozkład prawdopodobieństwa tych liter w jednym przebiegu. Dziesięć liter to zarazem limit: Basal przyjmuje od 2 do 10 opcji, Jev do 255. Pytanie może być wyborem jednej opcji, pytaniem tak albo nie, albo oceną na skali.
Model dostaje każde pytanie dwa razy, z opcjami w kolejności pierwotnej i odwróconej, a silnik uśrednia wyniki, bo to, co wybiera model językowy, zależy też od miejsca odpowiedzi na liście. Na koniec pewność jest kalibrowana osobno dla każdego typu pytania, tak żeby 0,9 znaczyło dziewięć trafień na dziesięć.
Najpierw pomiar: gdzie naprawdę jest luka
Praca zaczęła się od porównania Jeva z jedenastoma otwartymi modelami językowymi ogólnego przeznaczenia, między innymi Bielikiem i PLLuM-em, na zestawie 3 079 pytań. Najlepsze z nich traciły do Jeva od 12 do 13 punktów procentowych w polskiej wiedzy dziedzinowej, ale w decyzjach i rozumieniu tekstu tylko od 2 do 4. Kalibracja okazała się luką pozorną: wystarczył jeden współczynnik (tak zwana temperatura), dopasowany na połowie danych, żeby błąd kalibracji każdego otwartego modelu spadł do około 0,05 albo niżej. Stąd wybór pola rywalizacji: ile decyzji da się zautomatyzować przy ustalonym poziomie błędu. Drugi pomiar wybrał bazę: polski tokenizer Bielika, czyli sposób cięcia tekstu na kawałki, potrzebuje na polskich pytaniach najmniej tokenów, inne sprawdzone od 17 do 51% więcej.
Etykiety, które da się policzyć
Dane treningowe dobrano tak, żeby poprawna odpowiedź nie zależała od opinii jednego modelu. W większości są syntetyczne. Powstały na trzy sposoby, a ostatni punkt to zabieg, który utrudnia zgadywanie.
- Policzone kodem: terminy procesowe z kalendarzem dni wolnych, kwoty i progi, reguły z ustaw. Generator losuje fakty, a odpowiedź wylicza silnik reguł, bez udziału modelu językowego. To 51% danych treningowych.
- Napisane przez model i sprawdzone przez dwa inne, które odpowiadały, nie znając zamierzonej odpowiedzi. Przez to sito przeszło 5 613 z 15 000 przypadków, czyli 37%. To 22% danych.
- Przerobione z publicznych zbiorów, głównie angielskich. To 27% danych.
- Pary bliźniacze: ta sama sprawa z jednym zmienionym faktem, który zmienia odpowiedź. Model nie może zgadywać po powierzchownych cechach tekstu.
Jedna epoka, czyli jedno przejście przez dane, na 15 tysiącach przykładów podniosła trafność modelu 4.5B z 47,6% do ponad 82%, przy 68,6% dla Jeva na tym samym, pierwszym teście. Losowa kolejność opcji w treningu zmniejszyła odsetek odpowiedzi, które zmieniają się po odwróceniu listy, z 16,4% do 3,1%. Ostateczny zbiór ma 63 663 przykłady, a test korzysta z szablonów, ustaw i dziedzin, których model nie widział.
Jedno pytanie pozostało na poziomie rzutu monetą dla wszystkich systemów: czy pismo wniesiono w terminie. Po rozbiciu na dwa proste pytania, o ostatni dzień terminu i o datę wniesienia, oraz porównaniu dat w kodzie trafność modelu 4.5B na wcześniejszej wersji danych wzrosła z 48% do 92%, a Jeva z 52% do 69%. Wydany model po takim rozbiciu odpowiada bezbłędnie, a zapytany wprost wciąż trafia w 48%.
Pewność zamieniona na próg
Sama trafność nie mówi, ile pracy model zdejmie z ludzi. Raport mierzy więc pokrycie: jaka część decyzji przekracza próg pewności, poniżej którego sprawa idzie do człowieka. Próg ustalono na osobnej części danych, przed testem, tak żeby wśród zaakceptowanych decyzji był najwyżej 1% błędów. Model 4.5B rozstrzyga wtedy samodzielnie 58,6% z 8 560 decyzji testowych, polskich i angielskich, i myli się w 1,2% rozstrzygniętych. Jev w tej samej procedurze rozstrzyga 18,1%, przy 0,3% błędów.
Szybkość z serwowania, nie z modelu
Decyzja nie wymaga generowania tokenów, więc jej czas to czas jednego przebiegu modelu. Autor zauważa, że sam rachunek zajmuje karcie H100 kilka milisekund, a 32 ms zmierzone dla zwykłego przebiegu w precyzji 16‑bitowej to głównie koszt uruchamiania tysięcy małych operacji jedna po drugiej. Przyspieszano więc serwowanie, czyli sposób uruchamiania modelu i obsługi zapytań, a po każdej zmianie sprawdzano, czy decyzje zgadzają się z wersją wzorcową.

Największy pojedynczy skok dało przejście z precyzji 32‑bitowej na 16‑bitową: ze 176,5 do 32,9 ms. Ostatni krok działa, bo dwie kolejności opcji różnią się tylko końcówką: treść i pytanie to średnio 78% tokenów. Silnik liczy wspólny początek raz i dokleja do niego obie końcówki, więc druga kolejność kosztuje niewiele: 12,5 ms za obie wobec 11,6 ms za jedną. Na konsumenckiej RTX 5090 ta sama ścieżka daje 27,3 ms, na serwerowej B300 8,8 ms.
Co nie zadziałało
- Destylacja na zwykłych tekstach z sieci, czyli uczenie mniejszego modelu na przewidywaniach większego: pilotaż przerwany, bo polska wiedza spadła o 2 punkty. Działa dopiero destylacja na samych decyzjach, z której powstał model 1.5B.
- Wcześniejsze kończenie obliczeń skróciło czas tylko od 1,13 do 1,16 raza, bo decyzję da się odczytać dopiero w ostatnich dziesięciu z 60 warstw. W silniku zostało jako opcja dla modeli 1.0.
- Nowe dane z zadaniami na rozumowanie: plus 3,9 punktu na publicznym angielskim benchmarku, ale minus 0,6 na polskich decyzjach i minus 1,5 na ogólnym polskim zbiorze. Obie straty mieszczą się w jednym do dwóch błędów standardowych, ale regułę ustalono przed eksperymentem: nowa wersja zastępuje starą tylko wtedy, gdy polski nie traci. Nie zastąpiła.
Wynik i jego granice
Na 7 081 decyzjach testowych po polsku basal‑1.0 4.5B ma 88,4% trafności, basal‑1.0 1.5B 84,9%, Jev 1.13.0 78,0%, a najlepszy z jedenastu otwartych modeli decyzyjnych wzorowanych na Jevie, AutoJev‑27B, 77,9%. Wszystkie te liczby pochodzą z pomiarów samego autora modelu, a raport nie przeszedł recenzji naukowej.

- Polski zbiór testowy powstał z tych samych generatorów co dane treningowe. Autor pisze wprost, że to faworyzuje Basala.
- W pomiarach raportu przewaga nad Jevem pochodzi z dat, kwot i reguł ustawowych. W szerokich decyzjach biznesowych, takich jak kierowanie zgłoszeń czy ocena pilności, wyżej jest Jev: 93,8% wobec 89,0% w roboczych pomiarach z tabeli 10.
- Luka w polskiej wiedzy, od której zaczął się projekt, została: model 4.5B ma 58% wobec 79% dla Jeva. Raport radzi podawać potrzebne fakty w treści zapytania.
- Generator danych miał błędną regułę okresu wypowiedzenia z art. 36 § 1 Kodeksu pracy i źle oznaczył 125 przykładów. Wagi 1.0 powtarzają ten błąd; raport zapowiadał poprawkę w kolejnej wersji.
Co zmienia basal‑1.5
4 października autor opublikował basal‑1.5: trzy modele zamiast dwóch. Główny basal-1.5 ma nadal 4,5 mld parametrów, basal-1.5-max 11 mld i powstał z Bielika PL 11B, a basal-1.5-mini ma 1,5 mld i powstał przez destylację z modelu max. Wszystkie trzy mają ten sam interfejs, format zapytań i procedurę kalibracji, a limit to nadal 10 opcji. W treningu doszedł etap uczenia ze wzmocnieniem.
- Wiele pytań o ten sam tekst w jednym przebiegu: silnik liczy treść raz, więc pięć pytań zajmuje na H100 37,8 ms zamiast 111,7 ms.
- Nowe typy pytań:
multi, czyli które etykiety pasują, i eksperymentalnyact, który wybiera najtańszą akcję przy podanych kosztach błędu albo oddaje sprawę człowiekowi. - Eksperymentalne
evidence, czyli fragment tekstu wspierający odpowiedź, orazfacts, czyli policzone daty i kwoty dopisywane do polskiego tekstu. - Uruchomienie także przez vLLM i SGLang, na Macu przez MLX oraz przez Ollama i llama.cpp.
Najważniejsza zmiana dotyczy pomiaru. Na zamkniętym, niepublicznym teście autora, złożonym z 3 000 nowych polskich decyzji, przygotowanym po zamrożeniu wag i ocenionym raz, basal‑1.5 ma 93,1% wobec 87,4% dla wersji 1.0. Do zbioru testowego z raportu 1.0 zaglądano w trakcie prac, do tego nie.
Autor zbudował też Werdykt: ukryty test 5 000 decyzji po polsku i angielsku w 10 kategoriach, od reguł i terminów po długie dokumenty i umowy, z jednym protokołem dla wszystkich modeli. Tu obraz jest inny niż w raporcie 1.0. Jev ma 81,6%, otwarty Cygnet (12B) 78,5%, basal‑1.5‑max 77,3%, a basal‑1.5 72,1%. Najlepsze modele przez API przekraczają 98%, ale decyzja zajmuje im od 2 do 5,5 sekundy, a basal‑1.5 34 ms przy koszcie 0,048 dolara za tysiąc decyzji na wynajętej karcie H100 przy pełnym obciążeniu.

W kategorii reguł i terminów modele Basala mają od 30 do 35%, otwarty Cygnet 38%, a Gemini 3.8 Flash 100%. Rachunki nadal trzeba liczyć w kodzie. Na tych samych 8 560 decyzjach testowych co w raporcie basal‑1.5 przy progu 1% błędów rozstrzyga sam 51%, a ponownie uruchomiony basal‑1.0 55,2% (raport podawał 58,6%), ale nowa wersja myli się rzadziej: w 0,55% wobec 0,89% rozstrzygniętych.
Nasz test Basala na polskich danych, już na wersji 1.5, opiszemy w osobnym tekście.
Co z tego raportu wziąć do własnego projektu
- 01Zanim wybierzesz model, zmierz, gdzie jest luka: w wiedzy, w decyzjach czy tylko w kalibracji. Od tego zależy, czy potrzebujesz większego modelu, czy lepszych danych.
- 02Zbuduj zbiór testowy z etykietami, które da się policzyć albo sprawdzić w dokumencie. Opinia jednego modelu to za mało.
- 03Do każdej reguły dopisz parę bliźniaczą: jeden zmieniony fakt i inna poprawna odpowiedź.
- 04Od dostawcy modelu żądaj jednej liczby: ile decyzji przechodzi bez człowieka przy 1% błędów, z progiem ustalonym przed testem.
- 05Regułę, kiedy nowa wersja zastępuje starą, zapisz przed eksperymentem.
Źródła
- 01Remigiusz Kinas, basal‑1.0: Reliable, Highly Optimized Typed Decisions for Polish (technical report)opublikowano 28 września 2026
- 02rkinas/basal, inference engine and READMEwersja z 30 września 2026
- 03Hugging Face, model card Remek/basal‑1.0‑4.5Bostatnia aktualizacja 28 września 2026
- 04Hugging Face, leaderboard Remek/jev-pl-benchmarkostatnia aktualizacja 27 września 2026
- 05basal.si5.pl, basal‑1.0 - dynamiczny klasyfikatoropublikowano 1 października 2026
- 06basal.si5.pl, basal‑1.5: trzy modele, więcej możliwościopublikowano 4 października 2026
- 07basal.si5.pl, Werdykt benchmarkresults of 4 października 2026
- 08rkinas/basal, README of basal‑1.5wersja z 4 października 2026
- 09Hugging Face, model card Remek/basal‑1.5‑maxostatnia aktualizacja 3 października 2026
- 10Ociepa, Flis, Kinas, Wróbel, Gwoździej, Bielik v3 Small: Technical Reportv1 5 maja 2025, v2 8 maja 2025