Agenci w e-commerce: co dziś działa, zmierzone
Chatbot odpowiada na pytania. Agent sięga po narzędzia w Twoich systemach i wykonuje operację: sprawdza zamówienie, wystawia korektę, zakłada zgłoszenie u kuriera. Od dwóch lat istnieją publiczne testy, które mierzą, jak często mu się to udaje. Wyniki są lepsze, niż sądzą sceptycy, i wyraźnie niższe od tego, co obiecują prezentacje sprzedażowe.
W typowym sklepie internetowym obsługa klienta to kilkanaście powtarzalnych scenariuszy i długi ogon spraw nietypowych. Właściciele pytają nas najczęściej o dwie rzeczy: ile z tego da się oddać maszynie i jak bardzo można jej ufać. Na oba pytania da się dziś odpowiedzieć liczbami. Powstały publiczne testy, w których agenci obsługują symulowanych klientów w sklepie, a jedno głośne wdrożenie opublikowało zarówno obietnicę, jak i późniejsze rachunki.
Chatbot odpowiada, agent sięga po narzędzia
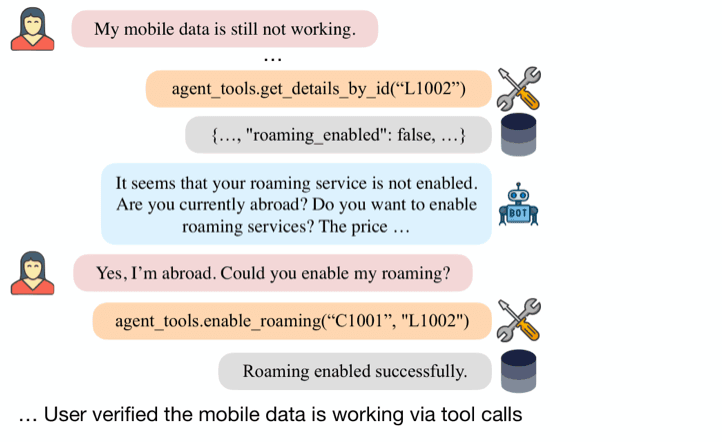
Anthropic, firma budująca modele, czyli programy generujące tekst, rozdziela te dwie rzeczy w swoim materiale inżynierskim z grudnia 2024 roku. Przepływ pracy to system, w którym model i narzędzia są prowadzone z góry zapisaną ścieżką w kodzie. Agent to system, w którym model sam kieruje swoim procesem i użyciem narzędzi, zachowując kontrolę nad tym, jak wykona zadanie. Narzędzie oznacza tu funkcję w Twoim systemie, którą model może wywołać: pobierz zamówienie, zmień adres wysyłki, wystaw zwrot.
Różnica dotyczy uprawnień. Ten sam model z dostępem wyłącznie do bazy wiedzy jest stroną z odpowiedziami na częste pytania, wstawioną w okno czatu. Daj mu prawo zapisu w systemie zamówień, a staje się wykonawcą, którego trzeba rozliczać z wyników jak każdego innego.

- Odczyt: stan zamówienia, historia klienta, dostępność w magazynie.
- Zapis: notatka w CRM, zgłoszenie do kuriera, korekta dokumentu.
- Reguły: co agent może zrobić samodzielnie, a co wymaga zgody człowieka.
Ile spraw agent domyka za pierwszym razem
Test najbliższy realiom e-commerce nazywa się tau-bench i został opublikowany w czerwcu 2024 roku. Działa prosto. Symulowany klient prowadzi rozmowę z agentem, agent ma zestaw narzędzi swojej branży oraz spisany regulamin, a na końcu porównuje się stan bazy danych ze stanem wzorcowym. Punkty daje stan systemu po rozmowie. Ładne zdania nie liczą się wcale.
Druga wersja, tau2‑bench z czerwca 2025 roku, mierzy trzy branże: sklep, linię lotniczą i telekom. W branży sklepowej Claude 3.7 Sonnet zalicza 79 procent spraw, a GPT‑4.1 74 procent. W linii lotniczej te same modele spadają do 50 i 56 procent, w telekomie do 49 i 34 procent. Sklep jest najłatwiejszą z trzech mierzonych branż i nadal mniej więcej co piąta sprawa kończy się źle.
Liczba, która decyduje: ta sama sprawa cztery razy
Skuteczność przy jednym podejściu mówi mało o tym, co zobaczy klient, bo w obsłudze ta sama sprawa wraca setki razy dziennie. Autorzy tau-bench wprowadzili więc miarę nazwaną pass^k: odsetek zadań, które agent zalicza we wszystkich k niezależnych przebiegach. Przy k równym jeden to zwykła skuteczność. Przy k równym cztery pytamy, czy agent poradzi sobie z tą samą sprawą cztery razy z rzędu.

W branży sklepowej Claude 3.7 Sonnet schodzi z 79 do 60 procent, a GPT‑4.1 z 74 do 53 procent. W telekomie ten sam Claude spada z 49 do 25 procent, czyli traci połowę wyniku. Oryginalna praca z 2024 roku podała liczbę jeszcze surowszą: agent oparty na GPT‑4o miał ponad 60 procent średniej skuteczności, a przy ośmiu powtórzeniach schodził poniżej 25 procent. To jest uczciwa liczba tej dziedziny i rzadko trafia na slajdy.
Agent, który sam klika w przeglądarce
Drugi rodzaj agenta nie dostaje gotowych narzędzi. Dostaje przeglądarkę i klika w strony tak jak człowiek. Zmierzyli to w 2025 roku autorzy pracy „An Illusion of Progress?”, ogłoszonej na konferencji COLM: 300 prawdziwych zadań ze 136 stron, każdy przebieg oceniany przez ludzi. Tytuł jest tu najważniejszą wskazówką.

Dwa najlepsze systemy, Operator od OpenAI i Claude Computer Use 3.7, kończą 61,3 i 56,3 procent zadań. Cztery pozostałe zatrzymują się w okolicach 30 procent. Dla Ciebie ważniejszy jest podział według długości zadania. Na zadaniach krótkich, które człowiek wykonuje w pięciu krokach lub mniej, Claude 3.7 osiąga 90,4 procent, a Operator 83,1 procent. Trudność rośnie przede wszystkim wraz z liczbą kroków.
Autorzy zrobili jeszcze jedną rzecz, o której warto wiedzieć przed rozmową z dostawcą. Zbudowali prymitywnego agenta, który potrafi tylko szukać w wyszukiwarce. Na starszym, popularnym teście WebVoyager taki agent zalicza 51 procent zadań. Na nowym zbiorze zalicza 22 procent: około 50 procent zadań łatwych, 18 procent średnich i 3 procent trudnych. Część głośnych wyników mierzy więc przede wszystkim łatwość zadań.
Co oddać agentowi najpierw
- Krótkie sprawy odczytowe: status zamówienia, przewidywany termin dostawy, dostępność rozmiaru. Pięć kroków lub mniej to obszar, w którym mierzone systemy dochodzą do 90 procent.
- Operacje odwracalne: zmiana adresu przed wysyłką, wygenerowanie etykiety zwrotnej, dopisanie notatki. Pomyłka kosztuje minutę pracy człowieka.
- Przygotowanie odpowiedzi dla człowieka: agent zbiera dane z trzech systemów i proponuje treść, a wysyła ją Twój zespół. Błąd nigdy nie dociera do klienta.
- Do człowieka: pieniądze wychodzące powyżej ustalonego progu, sporne reklamacje, sprawy z emocjami i wszystko, czego nie da się cofnąć jednym kliknięciem.
Ten podział wynika wprost z liczb. Skoro skuteczność spada wraz z długością zadania i wraz z liczbą powtórzeń, granicę uprawnień stawia się tam, gdzie koszt pomyłki zaczyna rosnąć szybciej niż oszczędność czasu. Anthropic zaleca w swoim materiale dwie proste bariery: przerwy na potwierdzenie przez człowieka w wyznaczonych punktach oraz twardy limit liczby kroków, po którym agent się zatrzymuje. W dokumencie pada też ostrzeżenie o kumulowaniu się błędów, gdy agent działa samodzielnie przez wiele kroków.
Jedno wdrożenie, które opublikowało obie strony rachunku
Klarna, szwedzka firma płatnicza, uruchomiła w lutym 2024 roku asystenta zbudowanego z OpenAI i po miesiącu ogłosiła wyniki. 2,3 miliona rozmów, dwie trzecie wszystkich czatów obsługi, „równowartość pracy 700 pełnoetatowych konsultantów”. Czas załatwienia sprawy spadł z 11 minut do poniżej 2 minut, liczba powracających zgłoszeń o 25 procent, obsługa na 23 rynkach i w ponad 35 językach, zadowolenie klientów „na równi z konsultantami”. Szacowany wpływ na zysk w 2024 roku: 40 milionów dolarów. W tym samym komunikacie jest zdanie, które łatwo przeoczyć: klienci nadal mogą wybrać rozmowę z żywym konsultantem, jeśli wolą.
Rok później te same rzeczy widać w raportach kwartalnych i wyglądają skromniej. W raporcie za pierwszy kwartał 2025 roku Klarna podaje koszt obsługi klienta na transakcję: 0,32 dolara w pierwszym kwartale 2023, 0,25 rok później i 0,19 w pierwszym kwartale 2025. To spadek o 40 procent w dwa lata, według firmy bez spadku zadowolenia konsumentów po wdrożeniu asystenta.
Jest też liczba, której nie ma na slajdach. W raporcie za trzeci kwartał 2025 roku pozycja kosztowa „obsługa klienta i operacje” wynosi 53 miliony dolarów wobec 44 milionów rok wcześniej. Koszt bezwzględny urósł o około 20 procent, przy przychodach wyższych o 28 procent. Automatyzacja poprawiła koszt jednostkowy i nie zlikwidowała działu. To dwie różne rzeczy i warto je rozróżnić, zanim podpiszesz budżet na podstawie nagłówka o 700 etatach.
Czego te liczby nie obiecują
Każdy z tych wyników pochodzi z cudzego środowiska. Sklep w tau2‑bench ma kilkanaście narzędzi i czystą bazę, a Twój ma integrację sprzed pięciu lat i trzy pola tekstowe, w których handlowcy trzymają notatki. Klient w tym teście jest symulowany przez model i zachowuje się grzeczniej niż prawdziwy. W zbiorze Online‑Mind2Web 47 procent zadań pobranych z wcześniejszego zestawu okazało się nieważnych albo miało nieaktualne rozwiązania, bo strony zdążyły się zmienić. Twoja strona zmienia się tak samo.
Jedyny wiarygodny test to Twoje zgłoszenia. Weź sto ostatnich spraw jednego typu, ustal na piśmie, co znaczy „załatwione”, i puść każdą z nich przez agenta kilka razy. Dopiero ten wynik mówi, czy agent może odpowiadać klientowi, czy na razie ma pracować dla Twojego zespołu. Jeśli chcesz przeprowadzić taki test u siebie, napisz do nas.
Źródła
- 01Yao et al., tau-bench: A Benchmark for Tool‑Agent‑User Interaction in Real‑World Domains, arXiv 2406.12045
- 02Barres et al., tau2‑Bench: Evaluating Conversational Agents in a Dual‑Control Environment, arXiv 2506.07982
- 03Xue et al., An Illusion of Progress? Assessing the Current State of Web Agents, COLM 2025
- 04Klarna, press release, 27 February 2024
- 05Klarna, Q1 2025 earnings release
- 06Klarna, Q3 2025 earnings press release