Skąd wiesz, że agent naprawdę działa
Uruchomienie systemu AI to łatwiejsza część wdrożenia. Trudniej wykazać, że działa nadal po zmianie instrukcji, aktualizacji modelu czy dodaniu narzędzia. Służy do tego ewaluacja, czyli stały zestaw przypadków testowych i ustalony sposób ich oceniania. Poniżej liczby z prac, które ten pomiar opisują, razem z tym, czego on nie obejmuje.
Zwykły test oprogramowania opiera się na jednym założeniu: to samo wejście daje to samo wyjście. Jeśli funkcja liczy podatek, sprawdzasz raz, że dla tysiąca złotych zwraca dwieście trzydzieści, i ten test jest ważny przez lata. System oparty na modelu językowym takiej gwarancji nie daje. Dwa przebiegi z identycznym zapytaniem potrafią pójść inną drogą, sięgnąć po inne narzędzie i skończyć się innym zdaniem. Test porównujący odpowiedź znak po znaku zacznie fałszywie alarmować pierwszego dnia.
Skoro nie da się sprawdzać dosłownej treści, sprawdza się skutek i powtarzalność. Skutek, czyli czy po rozmowie w bazie stoi to, co powinno stać. Powtarzalność, czyli czy ten sam przypadek kończy się tak samo, kiedy powtórzysz go kilka razy. Druga z tych rzeczy jest w praktyce ważniejsza i prawie zawsze pomijana w demach.
Jedna próba to za mało, żeby cokolwiek orzec
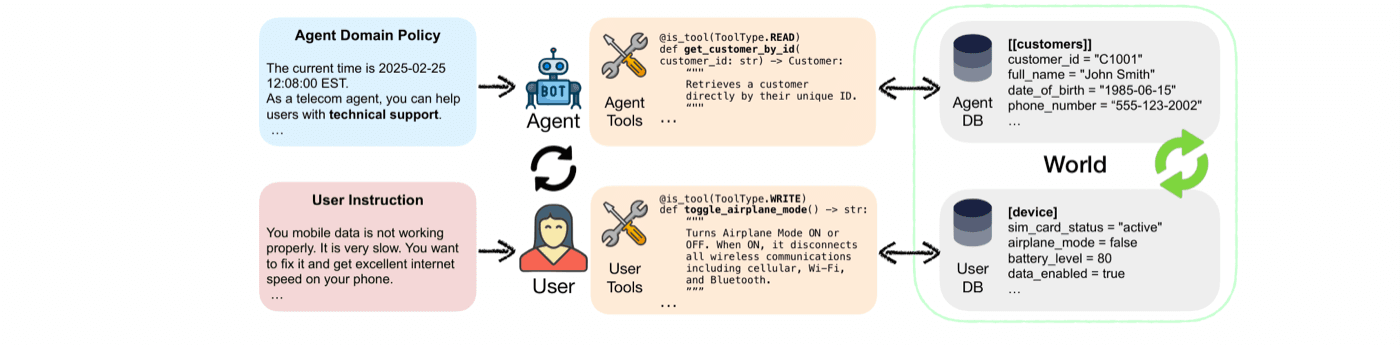
Firma Sierra opublikowała w 2024 roku τ-bench, czyli publiczny zestaw zadań, w których agent rozmawia z symulowanym klientem i korzysta z narzędzi. Ocena nie dotyczy brzmienia odpowiedzi: porównywany jest stan bazy danych na końcu rozmowy z zapisanym stanem docelowym. Autorzy dołożyli miarę pass^k, czyli odsetek spraw zaliczonych we wszystkich k kolejnych próbach. Ich własne podsumowanie brzmi tak: najlepsze ówczesne systemy zaliczały mniej niż połowę zadań, a w domenie sklepowej pass^8 spadało poniżej 25 procent.
Tabela wyników w repozytorium τ-bench podaje dokładne liczby. Najlepszy zmierzony tam agent, oparty na Claude 3.5 Sonnet z października 2024, zalicza w domenie sklepowej 69,2 procent spraw przy jednej próbie i 46,2 procent, gdy ta sama sprawa musi się udać cztery razy z rzędu. W domenie linii lotniczej, gdzie reguły są ostrzejsze, jest to 46,0 procent przy jednej próbie i 22,5 procent przy czterech. Praca opisuje 115 zadań w domenie sklepowej i 50 w lotniczej.

Ile przypadków wystarczy
Evan Miller z Anthropica opisał w 2024 roku, jak liczyć niepewność takich pomiarów, traktując zestaw testowy jak próbkę statystyczną. Z jego rachunku wynika liczba, która studzi entuzjazm: żeby wykryć różnicę trzech punktów procentowych między dwiema wersjami, przy mocy testu 80 procent i poziomie istotności 5 procent, potrzeba około 969 pytań. Mniejszy zestaw nie jest bezużyteczny, ale wykryje tylko różnicę dużą.
Ta sama praca podaje dwa sposoby, żeby zejść z tej liczby. Pierwszy to porównanie parami: zamiast liczyć osobno wynik starej i nowej wersji, liczysz różnicę pytanie po pytaniu, co usuwa z rachunku zmienność wynikającą z tego, że jedne pytania są po prostu trudniejsze. Drugi to powtarzanie każdego pytania kilka razy: przejście z jednej próby na dwie zbija wariancję o jedną trzecią, a cztery próby o połowę, przy granicy dwóch trzecich, której samym powtarzaniem nie przekroczysz.
- Trzydzieści prawdziwych zapytań z produkcji, w tym pięć takich, na których system już się wyłożył.
- Jednozdaniowy opis dobrej odpowiedzi dla każdego z nich, zapisany zanim zobaczysz wynik.
- Każdy przypadek uruchamiany co najmniej trzy razy, a raportowany wynik to odsetek przypadków zaliczonych za każdym razem.
- Ten sam zestaw uruchamiany na starej i nowej wersji tego samego dnia, bo porównanie parami jest znacznie czulsze niż dwa osobne pomiary.
Cztery sposoby oceniania jednej odpowiedzi
Ocena to osobna decyzja od zestawu przypadków i zwykle w jednym projekcie używa się kilku metod naraz.
- Reguły sztywne, czyli mechaniczne porównanie. OpenAI nazywa to w dokumentacji graderem string check, który zwraca jeden przy zgodności z wzorcem i zero w przeciwnym razie. Tanie, natychmiastowe, nadaje się do formatu i kategorii.
- Sprawdzenie faktów, czyli pytanie, czy w odpowiedzi jest właściwy numer zamówienia i czy stan bazy po rozmowie zgadza się z oczekiwanym. Tak działa ocena w τ-bench.
- Model jako sędzia, czyli drugi model czytający odpowiedź i wystawiający ocenę według rubryki. Anthropic w dokumentacji zaleca wprost, żeby sędzią był inny model niż ten, który odpowiedź wygenerował.
- Człowiek, czyli Twój pracownik oceniający próbkę. Najdroższy i najwolniejszy, więc trzymaj go do rzeczy, których nie da się opisać regułą.
Anthropic podaje w tej samej dokumentacji zasadę, która brzmi kontrowersyjnie, a jest praktyczna: lepiej mieć więcej pytań ocenianych automatycznie, nawet ze słabszym sygnałem, niż garść pytań ocenianych ręcznie. Ręczna ocena nie skaluje się do codziennego uruchamiania, a zestaw uruchamiany raz na kwartał nie wyłapie niczego na czas.
Na ile można ufać modelowi, który ocenia inny model
To pytanie ma zmierzoną odpowiedź. Zespół, który stworzył MT‑Bench i Chatbot Arena, zebrał oceny od 58 ekspertów, około 3000 głosów eksperckich i 30 000 rozmów z otwartej areny, a potem sprawdził, jak często model w roli sędziego zgadza się z człowiekiem. Licząc tylko głosy bez remisów, GPT‑4 zgadzał się z ekspertem w 85 procentach przypadków, podczas gdy dwóch ekspertów zgadzało się ze sobą w 81 procentach. Dla porównania dwóch losowych sędziów zgodziłoby się w 50 procentach.

Ta sama praca pokazuje granice metody. Zgodność zależy od tego, jak bardzo porównywane odpowiedzi się różnią: przy dużej różnicy jakości sięga niemal 100 procent, przy małej spada do około 70 procent. Autorzy wymieniają też trzy konkretne skrzywienia sędziego: preferowanie odpowiedzi pokazanej jako pierwsza, preferowanie odpowiedzi dłuższej i preferowanie własnych odpowiedzi. Kiedy człowiek nie zgadzał się z GPT‑4, po pokazaniu mu uzasadnienia modelu uznawał je za sensowne w 75 procentach przypadków i zmieniał zdanie w 34 procentach.
Wniosek praktyczny: model w roli sędziego nadaje się do wyłapywania wyraźnych różnic i do codziennego przesiewu, a nie do rozstrzygania, czy wersja A jest o dwa punkty lepsza od wersji B. Te dwa punkty trzeba rozstrzygnąć na ludzkiej próbce albo regułą.
Regresje, czyli poprawka psująca trzy inne sprawy
Najczęstszy sposób, w jaki wdrożenie AI cicho się pogarsza, wygląda tak: klient zgłasza jeden błędny przypadek, ktoś dopisuje zdanie do instrukcji, ten przypadek zaczyna działać, a trzy inne przestają. Bez zestawu uruchamianego przy każdej zmianie nikt tego nie zauważy, bo nikt tych trzech przypadków już nie sprawdza. Dlatego przypadek raz dodany do zestawu zostaje w nim na zawsze, także wtedy, gdy wydaje się załatwiony.
Warto też pamiętać, że sam zestaw testowy bywa źródłem błędów. Publiczny benchmark SWE‑bench, czyli zbiór prawdziwych zgłoszeń z GitHuba, liczy 2294 zadania, a jego wariant SWE‑bench Verified to 500 zadań ręcznie sprawdzonych przez inżynierów pod kątem tego, czy w ogóle da się je rozwiązać. Jeśli tak wygląda higiena znanego benchmarku, Twój zestaw trzydziestu przypadków też będzie wymagał przeglądu.
Co logować od pierwszego dnia
Ewaluacji nie da się dorobić wstecz, jeśli nie ma z czego zbudować przypadków. Logowanie kosztuje kilka godzin pracy na początku i decyduje o tym, czy za pół roku będzie co analizować.
- Pełne wejście, łącznie z załączonymi dokumentami i historią rozmowy.
- Wersję instrukcji i dokładną nazwę modelu, bo bez nich nie odtworzysz, co się zmieniło.
- Każde wywołanie narzędzia i to, co narzędzie odpowiedziało.
- Pełne wyjście oraz to, czy użytkownik je zaakceptował, poprawił czy porzucił.
- Identyfikator przebiegu, czas trwania i liczbę zużytych tokenów, czyli jednostek rozliczeniowych.
Ile kosztuje samo mierzenie
Mniej, niż się wydaje, dopóki liczysz tokeny zamiast zgadywać. Anthropic podaje w cenniku własny przykład: obsługa jednego zgłoszenia od klienta to średnio około 3700 tokenów, a dziesięć tysięcy takich zgłoszeń na modelu Claude Haiku 4.5 kosztuje około 37 dolarów. Zestaw dwustu przypadków uruchomiony pięciokrotnie to tysiąc takich przebiegów, czyli przy tej samej stawce około 3,70 dolara za cały ten pomiar.
Do tego dochodzi sędzia. Jeśli oceniasz każdą odpowiedź drugim modelem, płacisz drugi raz, a jeśli sędzia jest droższy od systemu, może to być rachunek wyższy niż sam pomiar. Cennik Anthropica podaje 1 dolara za milion tokenów wejściowych i 5 dolarów za milion wyjściowych dla Claude Haiku 4.5 oraz 2 i 10 dolarów dla Claude Sonnet 5, a tryb wsadowy, czyli przetwarzanie bez pośpiechu, zbija oba o połowę. Prawdziwym kosztem ewaluacji jest czas ludzi, którzy opisują, jak wygląda dobra odpowiedź, a nie rachunek za API.
Czego ten pomiar nie obiecuje
Zestaw testowy mierzy to, co do niego wpisałeś, i nic poza tym. Nie wykryje sytuacji, której nikt nie przewidział, bo takiej sytuacji w zestawie nie ma. Wynik 85 procent na własnym zestawie nie oznacza 85 procent na żywym ruchu, bo prawdziwi klienci piszą inaczej niż osoba układająca przypadki testowe. Liczby z τ-bench i MT‑Bench pochodzą z modeli i zadań z lat 2023 i 2024, więc traktuj je jako opis zjawiska, a nie prognozę dla Twojego systemu: spadek przy powtórzeniach jest realny, ale jego skala u Ciebie będzie inna.
Jedyny pomiar, który naprawdę coś przesądza, to Twoje przypadki, Twoja definicja dobrej odpowiedzi i porównanie dwóch wersji na tym samym zestawie tego samego dnia. Jeśli chcesz zobaczyć, jak taki zestaw wygląda dla Twojego procesu, napisz do nas. Zwykle wystarczy trzydzieści prawdziwych zapytań i godzina rozmowy o tym, co w nich znaczy sukces.
Źródła
- 01Yao et al., τ-bench: A Benchmark for Tool‑Agent‑User Interaction, arXiv 2406.12045
- 02Sierra Research, tau-bench, tabela wyników w repozytorium
- 03Zheng et al., Judging LLM‑as‑a‑Judge with MT‑Bench and Chatbot Arena, NeurIPS 2023
- 04Miller, Adding Error Bars to Evals, arXiv 2411.00640
- 05Anthropic, Create strong empirical evaluations
- 06Anthropic, Claude API pricing